一、项目概述
MOSS-TTS-Nano 是由 MOSI.AI 与 OpenMOSS 团队 联合开发的开源多语言小模型语音合成系统。模型参数量仅 0.1B,专为实时语音生成场景设计,无需 GPU 即可在 CPU 上直接运行,适合本地演示、Web 服务及轻量级产品集成。
核心技术架构
采用 Audio Tokenizer + LLM 的纯自回归流水线:
- 输入文本经文本正则化预处理
- 参考音频(提示语音)经音频分词器编码为离散 Token
- 轻量级语言模型以文本 Token 和音频 Token 为条件,自回归生成音频 Token
- 音频分词器解码器将 Token 流实时还原为 48 kHz、双声道波形
两种推理后端
| 特性 | PyTorch 版(app.py) | ONNX 版(app_onnx.py) |
|---|---|---|
| 推理依赖 | PyTorch | ONNX Runtime |
| 执行后端 | CUDA / CPU | CPU / CUDA(需 onnxruntime-gpu) |
| 推理效率 | 基准 | 约 2 倍于 PyTorch 版 |
| 单核 CPU 运行 | 可行 | 流畅运行(MacBook Air M4 实测) |
| 部署体积 | 包含 PyTorch 全家桶 | 无 PyTorch 依赖,更轻量 |
| 推荐场景 | 研究调试、GPU 环境 | 生产部署、CPU 环境(首选) |
二、软件功能特点
1. 语音克隆(Voice Clone)
- 提供一段参考音频(提示语音),模型即可模仿该说话人的音色、语调和风格
- 支持上传自定义音频文件(WAV、MP3、FLAC、M4A、OGG、Opus、AAC 等格式)
- 内置演示音频(位于
assets/audio/,通过assets/demo.jsonl配置) - 自动长文本分块克隆,超长文本无压力
2. 多语言支持
支持 20 种语言的语音合成:
| 语言 | 代码 | 语言 | 代码 | 语言 | 代码 |
|---|---|---|---|---|---|
| 中文 | zh | 英语 | en | 德语 | de |
| 西班牙语 | es | 法语 | fr | 日语 | ja |
| 意大利语 | it | 匈牙利语 | hu | 韩语 | ko |
| 俄语 | ru | 波斯语 | fa | 阿拉伯语 | ar |
| 波兰语 | pl | 葡萄牙语 | pt | 捷克语 | cs |
| 丹麦语 | da | 瑞典语 | sv | 希腊语 | el |
| 土耳其语 | tr |
3. 实时流式解码(Realtime Streaming Decode)
- 支持边生成边播放,首音延迟极低
- 使用 Web Audio API 进行 PCM 流式调度播放
- 实时显示已合成文本高亮,逐句跟踪播放进度
- 支持暂停/恢复播放
4. 丰富的生成参数调节
- 最大新帧数(Max New Frames):控制音频生成长度
- 文本/音频采样参数:Temperature、Top-P、Top-K
- 音频重复惩罚(Audio Repetition Penalty):减少音频伪影
- 随机种子(Seed):支持可复现生成
- 注意力后端(PyTorch 版):model_default / sdpa / eager
- 采样模式(ONNX 版):fixed(使用模型内置常量)/ full(使用页面超参数)/ greedy(贪心解码)
- 批量大小:TTS 批大小和编解码器批大小(ONNX 版固定为 1)
5. 文本正则化
- 内置 WeTextProcessing 文本正则化流水线
- 支持独立开关 WeTextProcessing 和
normalize_tts_text - 启动时预加载,首次请求无图构建延迟
- 正则化后文本实时展示在输出面板
6. 启动预热机制
- 服务启动时自动加载模型并执行一次短文本预热合成
- Web 界面实时显示预热进度和状态
- 预热失败时展示错误信息,便于排查
7. 可视化播放脚本高亮
- 将合成文本按语义分句,以卡片形式展示在播放面板中
- 播放时当前句子高亮显示,已播放句子以标记色标识
- 支持自动滚动跟随
三、启动方式
一键启动(Windows)
双击 0启动软件.bat,脚本自动调用 ONNX 版 Web 服务:
默认使用 ONNX CPU 后端。
四、界面功能说明
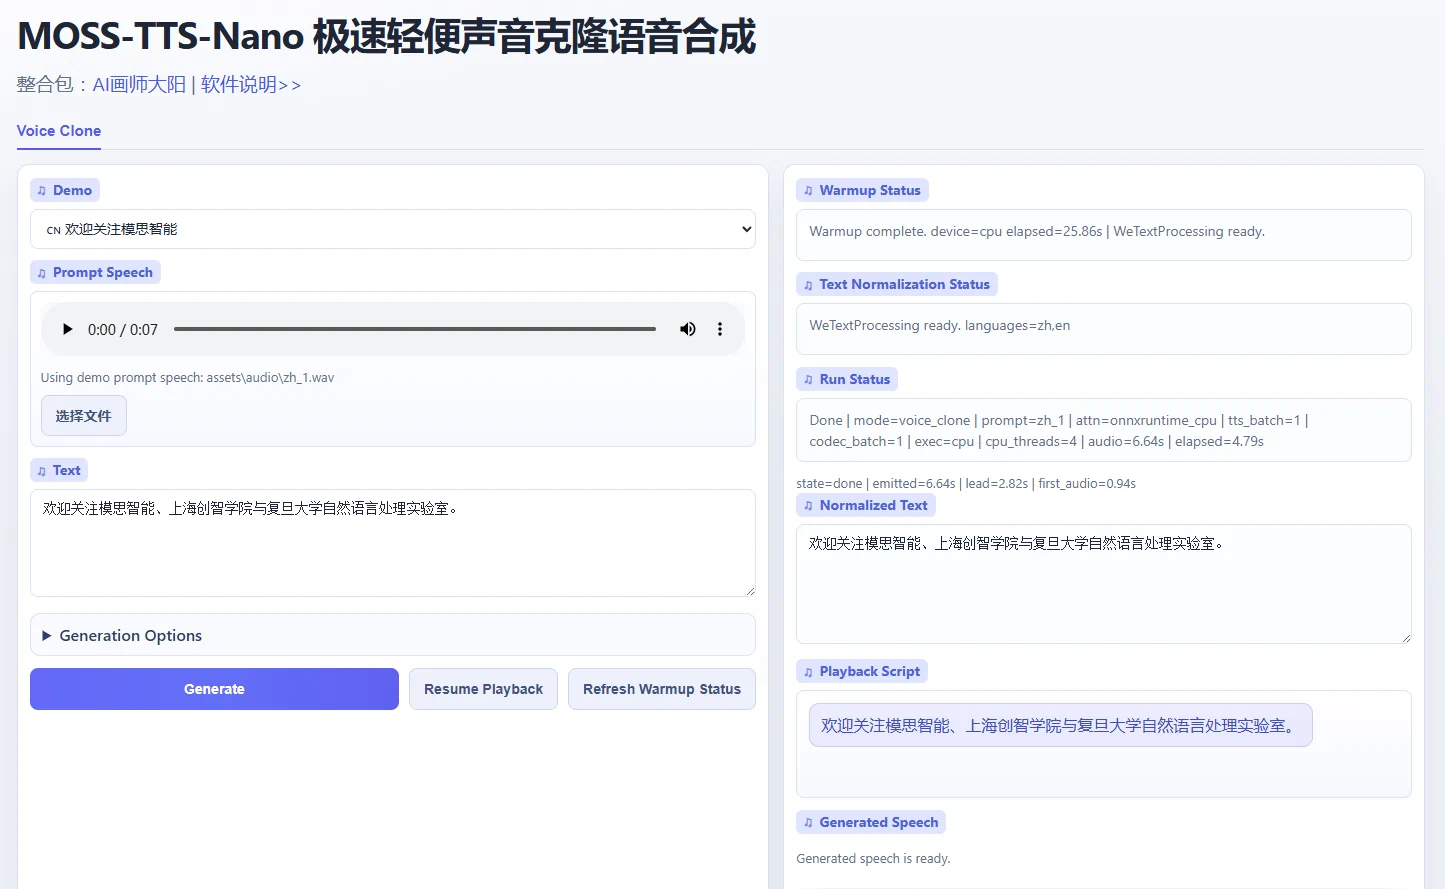
左侧面板(输入区)
| 区域 | 说明 |
|---|---|
| Demo 选择器 | 下拉选择内置演示条目,自动填充文本和参考音频 |
| 提示语音 | 上传自定义音频文件作为音色参考;可预览播放;支持切换回 Demo 音频 |
| 文本输入 | 输入要合成的文本内容 |
| 生成选项(可折叠) | 展开后可调节上述所有生成参数 |
| 生成按钮 | 触发合成,支持流式/缓冲两种模式切换 |
| 暂停播放 | 暂停/恢复当前音频播放 |
| 刷新预热状态 | 手动刷新模型加载和文本正则化状态 |
右侧面板(输出区)
| 区域 | 说明 |
|---|---|
| 预热状态 | 显示模型加载和预热进度百分比及状态信息 |
| 文本正则化状态 | 显示 WeTextProcessing 加载状态 |
| 运行状态 | 显示当前合成任务的实时状态和执行详情 |
| 流式指标 | 流式模式下显示延迟、已播放时长等技术指标 |
| 正则化文本 | 显示经过文本正则化处理后的文本 |
| 播放脚本 | 以卡片形式分句显示,播放时高亮当前句 |
| 生成音频 | 音频播放器,支持播放/暂停/进度拖拽 |
| 模型信息 | 底部显示当前使用的检查点路径和音频分词器路径 |
五、注意事项
硬件要求
- CPU 模式:建议 4 核以上 CPU,支持流式流畅运行
音频文件
- 上传的提示音频会暂存在
.app_prompt_uploads/目录,服务重启后清理 - 生成的音频文件保存到
generated_audio/目录 - 支持常见的音频格式:WAV、MP3、FLAC、M4A、OGG、Opus、AAC
- 建议参考音频时长 3~15 秒,过短可能导致克隆效果不佳
MOSS-TTS-Nano整合包软件下载链接
https://pan.quark.cn/s/90a215039c1b
相关推荐
 最强分说话人语音识别工具,支持批量音视频识别转字幕,字幕翻译内容总结
- AI实时语音聊天对话系统,外语口语陪练/虚拟好友实时语音交流
- 多人对话声音克隆语音合成工具Chatterbox TTS免安装版,AI实时文字转语音
- AI实时变声器Voice Changer2.1.4 CUDA版下载,高质量RVC变声软件
- 阿里Qwen3-TTS高质量声音克隆语音合成系统,AI视频配音多人对话生成工具
- 多人对话有声书制作软件VoxCPM Windows版整合包,高质量声音克隆语音合成工具
- 【免安装/解压即用】支持600+语言的神级TTS!OmniVoice 零样本语音克隆一键整合包发布
- FunASR语音识别转文字软件区分说话人版
最近更新
sand3d:面向 LLM 的 Python 3D 建模库,用短程序描述零件与装配
sand3d 是一个面向 LLM 的 Python 3D 建模库,用短程序按零件描述形状,支持关节、装配和多种格式导出,API 约 3,600 token,适合代码生成与仿真管线。
Pinky:让 AI 代理安全地操作你的 iPhone 或 Android 手机
Pinky 是一个 Go 编写的开源桌面应用,让 Claude Code、Codex、Cursor 等 MCP 代理安全地操作真实 iPhone 或 Android 手机。审批由网关强制执行,支付、删除等高风险操作需你确认,银行与密码类应用默认对代理不可见,每一步都有截图和录屏记录。
知了 Cicada:给任意会议和直播加实时双语字幕与同传的免费开源工具
知了 Cicada 是一款基于 Swift/SwiftUI 开发的免费开源实时字幕与会议纪要工具,支持 macOS、Windows、Linux 和 Android。它直接监听系统音频,为任意会议软件或直播提供双语字幕、同声传译和 AI 会议纪要,Apple 芯片 Mac 上语音识别全程本地完成。
Graphify:把代码库变成可查询知识图谱的 AI 编程助手技能
Graphify 是一个面向 Claude Code、Cursor、Codex、Gemini CLI 等 AI 编程助手的开源技能,用 tree-sitter 在本地把代码、文档、SQL schema、配置和 PDF 构建成可查询的知识图谱,支持查询、路径追踪和概念解释,且不依赖向量库。
Open WebUI:可离线自托管的 AI 界面,统一连接 Ollama 与 OpenAI 兼容 API
Open WebUI 是一个可离线自托管的 AI 交互平台,支持通过 Ollama 连接本地模型与 OpenAI 兼容 API,提供 Docker、Python 及桌面应用等多种运行方式。
Dify:在可视化画布上搭建 LLM 应用与 Agentic 工作流
Dify 是一个开源的 LLM 应用开发平台,把可视化 AI 工作流、RAG 管道、Agent、模型管理和 LLMOps 整合在同一工作空间,支持云端、VPC 或自托管部署,帮助团队从原型走向生产。
The Agency:把一支完整的 AI 专家团队装进你的开发工作流
The Agency 是一个开源的 AI 智能体角色合集,每个智能体都带有明确的专业方向、工作流程和交付物。它面向 Claude Code、Cursor、Codex、Gemini CLI 等工具,提供按部门组织的专家角色,并附带桌面安装器,可一键安装、按团队筛选。
Hugging Face Transformers:统一文本、视觉、音频与多模态模型的模型定义框架
Hugging Face Transformers 是一个覆盖文本、视觉、音频、视频和多模态的模型定义框架,支持推理与训练,并通过统一 API 连接主流训练框架和推理引擎。
n8n:可视化搭建与自定义代码结合的 AI 工作流自动化平台
n8n 是一个 fair-code 工作流自动化平台,支持可视化画布与 JavaScript、Python 代码混合搭建,可自托管或云端部署,并提供 AI 工作流、多步骤 agent、大量集成和工作流模板。本文介绍其功能、使用方式、运行环境与适用场景。
cinecode:用 AI 编程代理写剧本、造画面、配音效,把一句话变成 MP4 电影
cinecode 是一个在本地运行的 AI 电影生成工具包:AI 编程代理写剧本、用代码逐帧搭建画面、设计声音并输出 MP4,覆盖短片、长视频、广告、解说和音乐视频。本文介绍它的两种模式、两个创作目标、主要功能、运行环境和适用场景。