Umi-OCR是一款开源、免费的离线OCR文字识别软件。支持实时截屏/批量导入图片,PDF文档识别,排除水印/页眉页脚,扫描/生成二维码。内置多国语言库。原项目地址:https://github.com/hiroi-sora/Umi-OCR,应用截图如下:
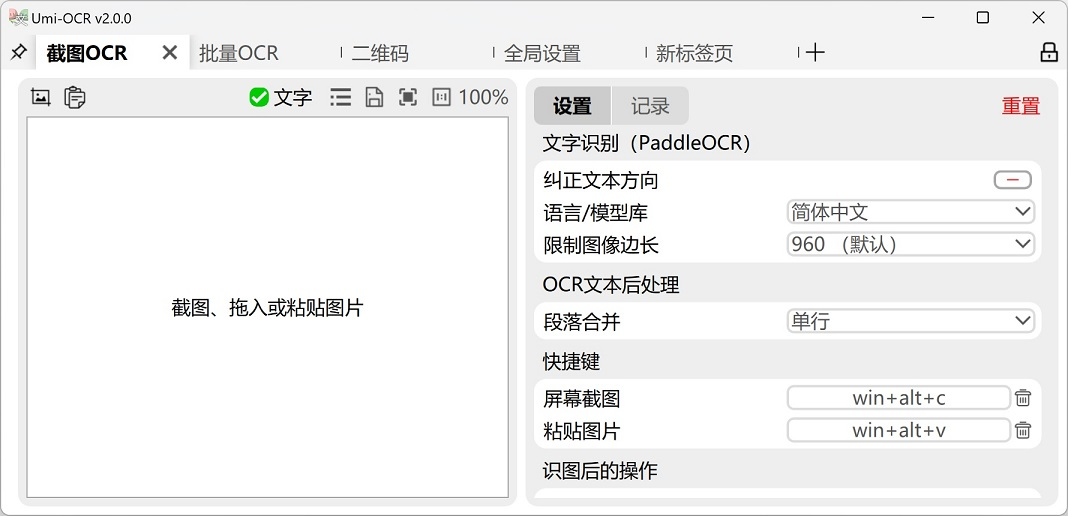
Umi-OCR软件特点:
- 免费:本项目所有代码开源,完全免费。
- 方便:解压即用,离线运行,无需网络。
- 高效:自带高效率的离线OCR引擎,内置多种语言识别库。
- 灵活:支持命令行、HTTP接口等外部调用方式。
- 功能:截图OCR / 批量OCR / PDF识别 / 二维码 / 公式识别
软件功能介绍:
软件发布包下载为 .7z 压缩包或 .7z.exe 自解压包。自解压包可在没有安装压缩软件的电脑上,解压文件。本软件无需安装。解压后,点击 Umi-OCR.exe 即可启动程序。【Paddle版性能好,但不兼容奔腾、赛扬、凌动CPU。Rapid兼容绝大部分硬件。】
界面语言
Umi-OCR 支持的界面多国语言。在第一次打开软件时,将会按照你的电脑的系统设置,自动切换语言。
如果需要手动切换语言,请参考下图,全局设置→语言/Language 。
标签页
Umi-OCR v2 由一系列灵活好用的标签页组成。您可按照自己的喜好,打开需要的标签页。
标签栏左上角可以切换窗口置顶。右上角能够锁定标签页,以防止日常使用中误触关闭标签页。
截图OCR
截图OCR:打开这一页后,就可以用快捷键唤起截图,识别图中的文字。
- 左侧的图片预览栏,可直接用鼠标划选复制。
- 右侧的识别记录栏,可以编辑文字,允许划选多个记录复制。
- 也支持在别处复制图片,粘贴到Umi-OCR进行识别。
- 关于 公式识别 功能
文本后处理
关于 OCR文本后处理 – 排版解析方案: 可以整理OCR结果的排版和顺序,使文本更适合阅读和使用。预设方案:
多栏-按自然段换行:适合大部分情景,自动识别多栏布局,按自然段规则进行换行。多栏-总是换行:每段语句都进行换行。多栏-无换行:强制将所有语句合并到同一行。单栏-按自然段换行/总是换行/无换行:与上述类似,不过 不区分多栏布局。单栏-保留缩进:适用于解析代码截图,保留行首缩进和行中空格。不做处理:OCR引擎的原始输出,默认每段语句都进行换行。
上述方案,均能自动处理横排和竖排(从右到左)的排版。(竖排文字还需要OCR引擎本身支持)
批量OCR
批量OCR:这一页用于批量导入本地图片进行识别。
- 支持格式:
jpg, jpe, jpeg, jfif, png, webp, bmp, tif, tiff。 - 保存识别结果的支持格式:
txt, jsonl, md, csv(Excel)。 - 与截图OCR一样,支持
文本后处理功能,整理OCR文本的排版和顺序。 - 没有数量上限,可一次性导入几百张图片进行任务。
- 支持任务完成后自动关机/待机。
- 如果要识别像素超大的长图或大图,请调整:页面的设置→文字识别→限制图像边长→【调高数值】。
- 拥有特殊功能
忽略区域。
忽略区域
关于 OCR文本后处理 – 忽略区域: 批量OCR中的一种特殊功能,适用于排除图片中的不想要的文字。
- 在批量识别页的右栏设置中可进入忽略区域编辑器。
- 如上方样例,图片顶部和右下角存在多个水印 / LOGO。如果批量识别这类图片,水印会对识别结果造成干扰。
- 按住右键,绘制多个矩形框。这些区域内的文字将在任务中被忽略。
- 请尽量将矩形框画得大一些,完全包裹住水印所有可能出现的位置。
- 注意,只有处于忽略区域框内部的整个文本块(而不是单个字符)会被忽略。如下图所示,黄色边框的深色矩形是一个忽略区域。那么只有
key_mouse才会被忽略。pubsub_connector.py、pubsub_service.py这两个文本块得以保留。
文档识别:
- 支持格式:
pdf, xps, epub, mobi, fb2, cbz。 - 对扫描件进行OCR,或提取原有文本。可输出为 双层可搜索PDF 。
- 支持设定 忽略区域 ,可用于排除页眉页脚的文字。
- 可设置任务完成后 自动关机/休眠 。
二维码
扫码:
- 截图/粘贴/拖入本地图片,读取其中的二维码、条形码。
- 支持一图多码。
- 支持19种协议,如下:
Aztec,Codabar,Code128,Code39,Code93,DataBar,DataBarExpanded,DataMatrix,EAN13,EAN8,ITF,LinearCodes,MatrixCodes,MaxiCode,MicroQRCode,PDF417,QRCode,UPCA,UPCE
生成码:
- 输入文本,生成二维码图片。
- 支持19种协议和纠错等级等参数。
全局设置
全局设置:在这里可以调整软件的全局参数。常用功能如下:
- 一键添加快捷方式或设置开机自启。
- 更改界面语言。Umi支持繁中、英语、日语等语言。
- 切换界面主题。Umi拥有多个亮/暗主题。
- 调整界面文字的大小和字体。
- 切换OCR插件。
- 渲染器:软件界面默认支持显卡加速渲染。如果在你的机器上出现截屏闪烁、UI错位的情况,请调整
界面和外观→渲染器,尝试切换到不同渲染方案,或关闭硬件加速。
免费离线图片文字识别工具Umi-OCR软件下载链接:
夸克网盘:
https://pan.quark.cn/s/f23ce2030b2f
百度网盘:
https://pan.baidu.com/s/1MaG8F6-gUIlPuyJ8FsoMFA?pwd=7brp 提取码: 7brp
相关推荐
最近更新
The Agency:把一支完整的 AI 专家团队装进你的开发工作流
The Agency 是一个开源的 AI 智能体角色合集,每个智能体都带有明确的专业方向、工作流程和交付物。它面向 Claude Code、Cursor、Codex、Gemini CLI 等工具,提供按部门组织的专家角色,并附带桌面安装器,可一键安装、按团队筛选。
Hugging Face Transformers:统一文本、视觉、音频与多模态模型的模型定义框架
Hugging Face Transformers 是一个覆盖文本、视觉、音频、视频和多模态的模型定义框架,支持推理与训练,并通过统一 API 连接主流训练框架和推理引擎。
n8n:可视化搭建与自定义代码结合的 AI 工作流自动化平台
n8n 是一个 fair-code 工作流自动化平台,支持可视化画布与 JavaScript、Python 代码混合搭建,可自托管或云端部署,并提供 AI 工作流、多步骤 agent、大量集成和工作流模板。本文介绍其功能、使用方式、运行环境与适用场景。
cinecode:用 AI 编程代理写剧本、造画面、配音效,把一句话变成 MP4 电影
cinecode 是一个在本地运行的 AI 电影生成工具包:AI 编程代理写剧本、用代码逐帧搭建画面、设计声音并输出 MP4,覆盖短片、长视频、广告、解说和音乐视频。本文介绍它的两种模式、两个创作目标、主要功能、运行环境和适用场景。
gputaskman:给 GPU 装一个 htop,逐进程看清显存都被谁占了
gputaskman 是一个用 Python 编写的终端 GPU 任务管理器,试图回答“显存到底被谁占了”:它把逐进程显存、GPU 引擎活动与运行时、模型文件、LLM 的权重/KV cache 拆解关联起来,支持 Windows、Linux、WSL 和 Apple Silicon。本文介绍其功能、安装方式、平台限制与适用场景。
开发一次,四个平台原生运行:Exact 想做的 AI 原生跨平台应用运行时
Exact 是一个跨平台应用运行时:用小型声明式语言 Contract 描述界面,用 TypeScript 或 Rust 写数据逻辑,编译出的界面计划在 Web、macOS、iOS 和 Linux 上以各平台原生方式运行,并允许 AI 编码代理通过统一操作脚本构建、运行、观察和测试应用。
Hermes Agent:Nous Research 开源的自我改进 AI 智能体,能从经验中创建技能并跨平台运行
Hermes Agent 是 Nous Research 开源的自我改进 AI 智能体,内置学习闭环,能从经验中创建并改进技能,支持多消息平台、定时任务、子智能体和多种运行后端,可用任意模型并通过 CLI 或 Telegram 等入口使用。
TradingAgents 是什么:用多智能体 LLM 模拟交易公司的开源框架
TradingAgents 是一个基于 LangGraph 的多智能体 LLM 金融交易研究框架,用分析师、研究员、交易员和风险管理团队的分工模拟交易公司决策流程。本文介绍它的角色设计、安装方式、LLM 提供商配置、CLI 用法、支持市场与 Python 调用方式。
llama.cpp:用 C/C++ 实现本地大模型与视觉语言模型推理
llama.cpp 是一个用 C/C++ 编写的 LLM 与 VLM 推理项目,构建在 ggml 之上,支持多种 CPU 指令集、量化方案和 GPU/NPU 后端,并提供 CLI、server 等工具。本文依据其 GitHub README 介绍项目定位、功能特点、安装方式与适用场景。
ECC:给 AI 编码代理加装一套工程化流程与工具箱
ECC 是面向 AI 编码代理的工程化流程系统,提供 71 个代理、314 个技能、钩子、记忆与安全扫描,主要支持 Claude Code,并为 Codex、Cursor 等提供适配路径。